Wat zijn volgorde- en oefeneffecten in associatiemetingen?
Hoe beïnvloeden taakvolgorde, oefenen en herhaling een associatietest? Over counterbalancing, IAT, pre-postmetingen en betrouwbaarder onderzoek.
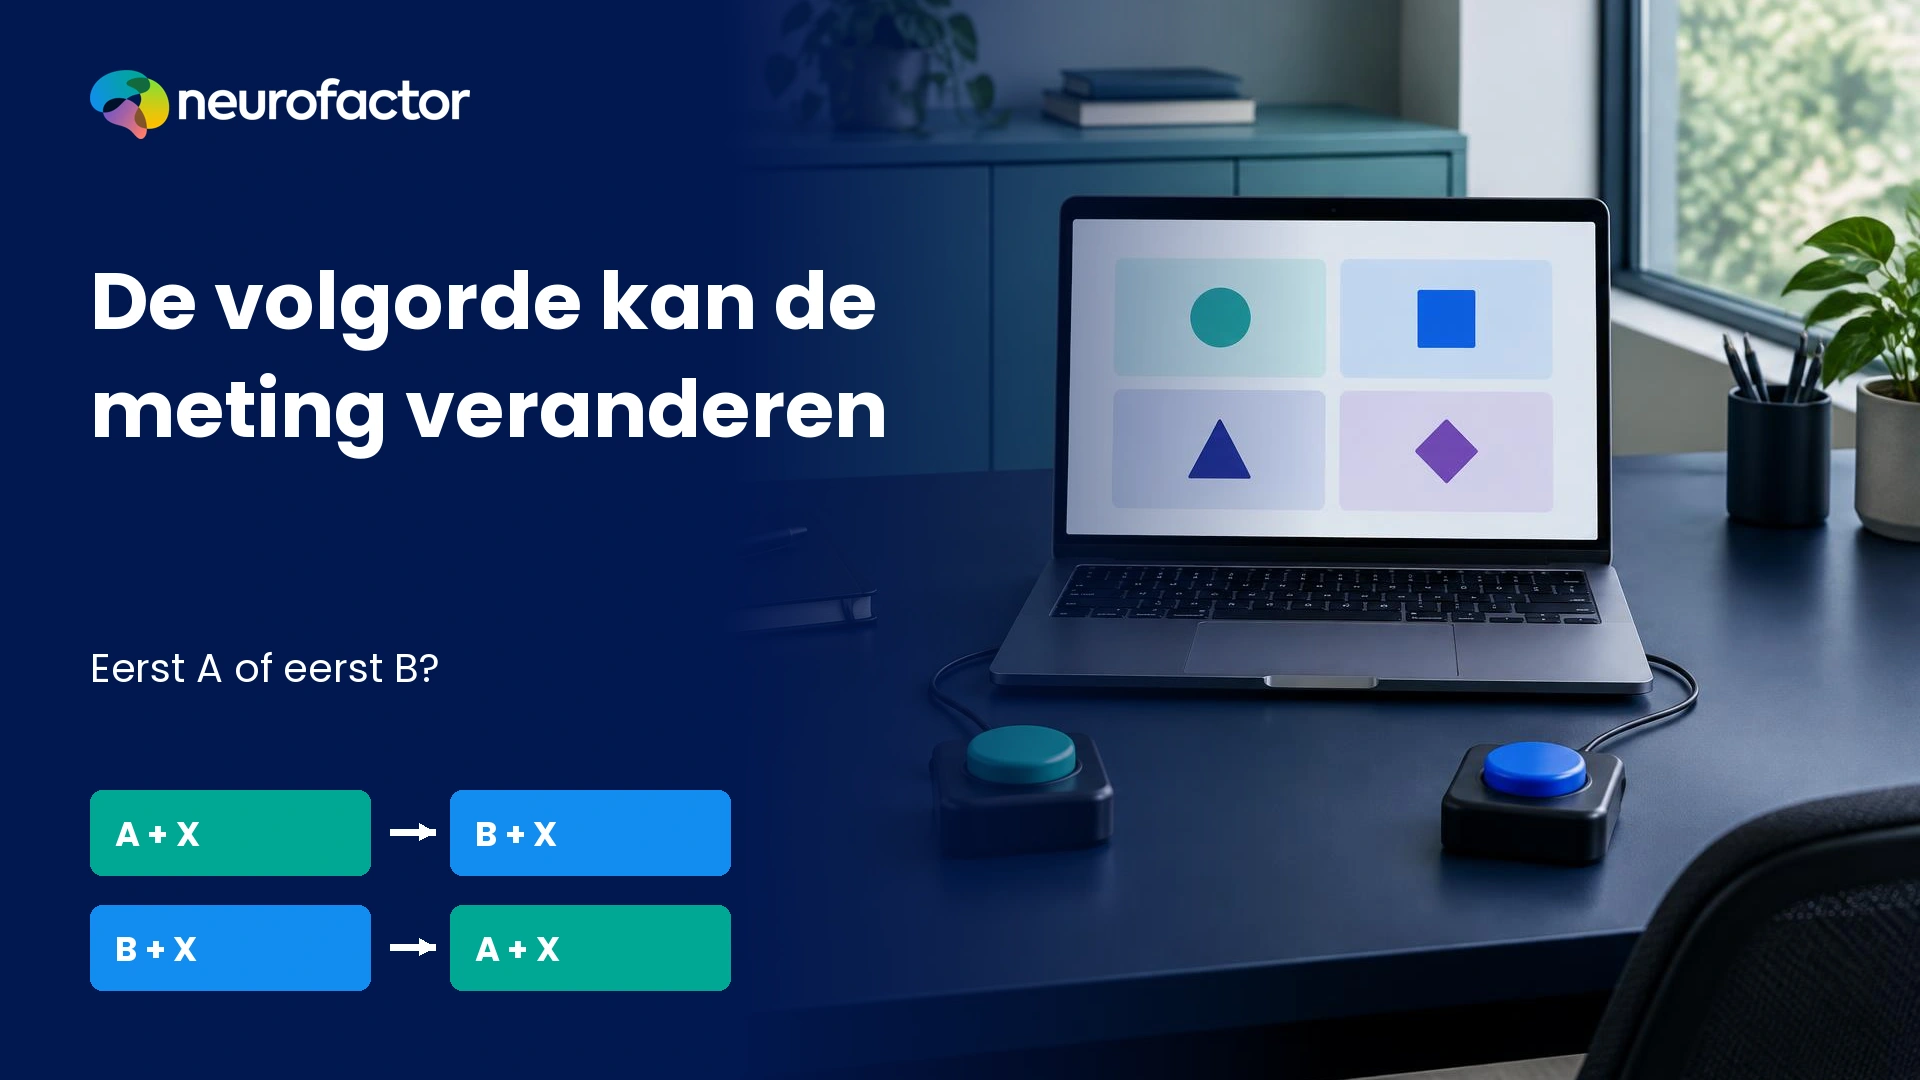
Een associatietest toont niet alleen hoe deelnemers twee combinaties verwerken, maar kan ook weerspiegelen welke taak eerst kwam en hoeveel oefening zij kregen. Dit artikel laat zien hoe je dat onderscheid onderzoekt.
Waarom de volgorde van twee metingen ertoe doet
Stel dat je onderzoekt welke betekenissen mensen verbinden aan twee fictieve werkgevers. De eerste combinatie op het scherm koppelt werkgever A aan 'vertrouwen'. Daarna draaien de antwoordtoetsen om. Je ziet een verschil in reactietijd. Komt dat doordat A sterker met vertrouwen verbonden is? Of doordat deelnemers in de eerste ronde een responsregel hebben aangeleerd en die bij de tweede ronde moeten loslaten?
Dat zijn verschillende verklaringen voor hetzelfde waarneembare resultaat. Een goede meting onderscheidt daarom het inhoudelijke contrast van de procedure waarmee het contrast zichtbaar wordt gemaakt. Niet omdat reactietijden waardeloos zouden zijn, maar omdat hun betekenis afhangt van de taakcontext.
In het kennisbankartikel Wat betekenen reactietijden in impliciet associatieonderzoek? staat de basis van responslatenties en relatieve taakprestaties. Dit tweede kennisbankartikel behandelt één scherp afgebakende vraag: hoe voorkomen we dat volgorde, oefenen of vermoeidheid voor een associatief verschil worden aangezien? Het bestaande overzicht Hoe meet je associaties? blijft het startpunt voor de keuze tussen meetmethoden.
Wat bedoelen we met een volgorde-effect?
Een volgorde-effect ontstaat wanneer de positie van een taak, stimulus, vraag of conditie invloed heeft op het gemeten resultaat. Twee deelnemers kunnen precies dezelfde categorieën beoordelen, maar verschillende procedures doorlopen. De een begint met combinatie A en eindigt met B; de ander doorloopt B en daarna A. Als die volgorde gemiddeld uitmaakt voor hun prestaties, is het niet voldoende alleen de uitkomst van A en B te vergelijken.
Een volgorde-effect is niet hetzelfde als een associatie-effect. Soms ontstaat het door het leren van een regel, soms door interferentie van eerdere antwoordkoppelingen, door een veranderende strategie of door vermoeidheid. In praktijkonderzoek kunnen ook verwachtingen, instructies en de volgorde van verschillende meetinstrumenten meespelen.
Er bestaan minstens drie verschillende volgordevragen die je niet door elkaar moet halen:
- Blokvolgorde: welke gecombineerde categorie-indeling krijgt de deelnemer eerst?
- Stimulus- en toetsvolgorde: welke woorden, beelden en antwoordzijden verschijnen achtereenvolgens?
- Meetmomentvolgorde: wanneer volgt de associatietaak ten opzichte van een vragenlijst, interventie of eerdere testafname?
Voor ieder niveau heb je een andere controle nodig. Een omgekeerde volgorde van IAT-blokken lost bijvoorbeeld geen ongelijk verdeelde pre-postblootstelling op.
Hoe ontstaat een blokvolgorde-effect in de IAT?
Bij een klassieke IAT sorteren deelnemers stimuli die horen bij twee doelcategorieën en twee attribuutcategorieën. In één gecombineerde blokvariant delen bepaalde categorieën een antwoordtoets. In de andere variant wordt de koppeling omgedraaid. De taak meet de relatieve prestatie in die twee combinaties [1].
De eerste combinatie wordt niet onder dezelfde leeromstandigheden uitgevoerd als de tweede. Deelnemers wennen aan de opdracht, ontwikkelen een toetsrespons en bouwen een tijdelijke taakinstelling op. Wanneer de tweede gecombineerde taak begint, moet die eerdere instelling deels worden vervangen. Onderzoekers spreken hier onder meer over task-set inertia: een eerder aangeleerde taakregel werkt door nadat de taak is veranderd [4, 5].
Dat betekent niet dat het hele IAT-effect slechts een volgordefout is. Het betekent wel dat het gemeten verschil meerdere componenten kan bevatten. Klauer en Mierke lieten zien dat eerdere IAT-blokken de prestatie op latere evaluatieve taken konden beïnvloeden. Hun bevindingen ondersteunen het belang van taakwisselprocessen bij compatibiliteitsvolgorde [5].
Een onderzoeksrapport dat alleen zegt 'de eerste combinatie was sneller' mist daarom essentiële informatie. We moeten weten welke groep die combinatie eerst kreeg, hoeveel oefening plaatsvond en of het patroon in beide volgordes vergelijkbaar is.
Counterbalancing: dezelfde vergelijking in beide richtingen
Counterbalancing betekent dat de onderzoeker de mogelijke taakvolgordes doelbewust verdeelt. Een deel van de deelnemers krijgt eerst A en daarna B. Een ander deel krijgt eerst B en daarna A. Idealiter gebeurt dit binnen iedere experimentele conditie en, waar relevant, binnen belangrijke doelgroepsegmenten [7].
| Ontwerpgroep | Eerste gecombineerde taak | Tweede gecombineerde taak | Wat controleren we? |
|---|---|---|---|
| Groep 1 | Werkgever A + vertrouwen | Werkgever B + vertrouwen | Prestatie bij volgorde A-B |
| Groep 2 | Werkgever B + vertrouwen | Werkgever A + vertrouwen | Prestatie bij volgorde B-A |
Dit is een schematisch ontwerp met fictieve categorieën. De werkelijke IAT bevat aanvullende categoriekoppelingen en oefenblokken.
Als het gemiddelde verschil sterk verandert wanneer je de volgorde omdraait, is dat een signaal dat het taakontwerp mede het resultaat bepaalt. Door beide volgordes te meten, kun je het effect onderzoeken in plaats van aannemen dat het niet bestaat.
Een eerlijke verdeling is méér dan 'we hebben willekeurig toegewezen'. Controleer hoeveel deelnemers uiteindelijk in elke volgorde zitten. Wanneer een selecte groep uitvalt, kan de uiteindelijke verdeling scheef worden. Als je een interventie met een controlegroep vergelijkt, hoort de taakvolgorde bovendien binnen beide groepen te worden verdeeld. Anders kan het gevonden interventieverschil een procedureverschil zijn.
Afbeelding
Wat counterbalancing wel en niet oplost
Counterbalancing verdeelt een mogelijke verstorende invloed over onderzoekscondities; het maakt die invloed niet ongedaan bij iedere individuele deelnemer. Ook een volledig gebalanceerde studie kan nog variatie in concentratie, gevoeligheid voor regelswitches of verschillen in stimuli bevatten.
Bij groepsvergelijkingen helpt de werkwijze om te voorkomen dat één groep toevallig een gunstiger taakvolgorde krijgt. Bij individuele uitspraken is het effect beperkter: één deelnemer heeft nog steeds maar één feitelijke volgorde doorlopen, tenzij het protocol expliciet herhaalde afnames omvat.
De 2022-methodologische aanbevelingen voor de IAT beschrijven counterbalancing van de gecombineerde taakvolgorde als doorgaans wenselijk. Ze benoemen ook het balanceren van de begintoewijzing van categorieën aan linker- en rechtertoetsen [7]. Dit zijn aanbevelingen voor onderzoeksontwerp, geen garantie dat een specifieke score alle mogelijke bias uitsluit.
Voor een studie met verschillende doelgroepen komt daar nog iets bij: zorg dat de verdeling niet alleen in de totale steekproef klopt, maar ook dat relevante condities voldoende vertegenwoordigd zijn om de vergelijking te kunnen beoordelen. Is een subgroep te klein, rapporteer dat dan als beperking in plaats van een schijnbaar precies effect te presenteren.
Oefeneffecten: sneller worden zonder andere associatie
Een oefeneffect ontstaat wanneer prestaties veranderen doordat iemand ervaring opdoet met de taak. De deelnemer kent na enige tijd de categorieën, weet welke toets bij welke instructie hoort en hoeft minder lang te zoeken naar de juiste respons.
Bij een IAT kan oefening twee richtingen op werken. Algemene taakbekendheid kan antwoorden in latere blokken versnellen. Maar de eerder aangeleerde toetsindeling kan ook hinderen wanneer categorieën omschakelen. Het netto-effect kan afhangen van de hoeveelheid oefening en van de precieze taakvariant [3, 4].
Dit is het verschil tussen 'de deelnemer leert de taak' en 'de deelnemer verandert van mening'. Beide kunnen samen voorkomen, maar dezelfde gemeten versnelling bewijst niet welk proces verantwoordelijk was.
Dat onderscheid is extra belangrijk wanneer een organisatie de associatieonderzoeksmethode herhaaldelijk inzet. Bekendheid met de test zelf kan groeien, ook wanneer de onderliggende betekenis van een merk, werkgever of gedragsoptie stabiel blijft. Een vergelijking met een eerdere meting vraagt daarom meer dan gelijke woorden op het scherm.
Waarom extra omschakeloefening kan helpen
Een klassieke IAT bevat oefen- en gecombineerde taakblokken. Vooral vóór de omgekeerde gecombineerde taak is het belangrijk dat deelnemers de nieuwe toetstoewijzing begrijpen. In onderzoek van Nosek, Greenwald en Banaji uit 2005 verminderde aanvullende oefening in het omgeschakelde categorisatieblok een bekend ongewenst volgorde-effect aanzienlijk [3].
De praktische les is niet dat 'veertig oefentrials altijd genoeg zijn'. Het gevonden resultaat had betrekking op een specifiek onderzoeksprotocol. De geschikte oefenlengte hangt af van taakopbouw, stimuli, doelgroep en empirische controle. Een onderzoeker moet dus vastleggen welke versie van de taak is gebruikt en waarom de gekozen bloklengten bij die versie passen.
Te weinig oefening kan leiden tot een groot verschil in taakbekendheid. Maar een ongelimiteerd aantal proeven is evenmin vanzelfsprekend beter: langere taken kunnen verveling, vermoeidheid of uitval introduceren. Het juiste doel is voldoende begrip en stabiele uitvoering, niet simpelweg zo veel mogelijk herhaling.
Herhaalde metingen: wanneer pre-post een valkuil wordt
Stel dat je vóór een communicatiecampagne een associatietest afneemt en drie weken later opnieuw. De gemiddelde score beweegt richting nul. De verleiding is groot om te zeggen dat de campagne het verschil heeft veroorzaakt.
Maar herhaalde IAT-afnames kunnen op zichzelf de score beïnvloeden. De methodologische aanbevelingen van Greenwald en collega's beschrijven dat een eerste IAT-afname gemiddeld sterker van nul kan afwijken dan een tweede of latere afname. Zonder aanvullende controle kan een vermindering daardoor ten onrechte als interventie-effect worden geïnterpreteerd [7].
Twee strategieën zijn bijzonder relevant:
- Een controlegroep die eveneens beide meetmomenten doorloopt. Dan kun je vergelijken of de verandering in de interventiegroep afwijkt van de verandering die ook zonder interventie optreedt.
- Gestandaardiseerde voorafgaande taakervaring. Alle deelnemers kunnen ervaring opdoen met een passende IAT-procedure vóór de daadwerkelijke nulmeting, mits dit vooraf methodologisch is onderbouwd.
Beide aanpakken vragen een protocol. Een controlegroep moet voldoende vergelijkbaar zijn, en vooraf oefenen mag het te meten construct niet onbedoeld veranderen. In een goede analyse geef je daarom niet alleen de score vóór en na, maar ook de feitelijke verschillen tussen onderzoekscondities, de meetonzekerheid en de alternatieve verklaringen.
Afbeelding
Vermoeidheid, aandacht en de afweging tussen snelheid en nauwkeurigheid
Een deelnemer die aan het eind van een lang onderzoek minder geconcentreerd is, kan trager antwoorden of meer fouten maken. Een ander kan juist versnellen door minder voorzichtig te zijn. De totale reactietijd laat niet automatisch zien welke verklaring klopt. Daarom horen nauwkeurigheid, foutafhandeling en taakduur bij de interpretatie [2].
Het is verstandig om sessieduur, eventuele onderbrekingen, plaats van de taak in een langere vragenlijst en apparatuur vast te leggen. Bij remote onderzoek moet je rekening houden met variatie in invoerapparaten en omgevingsomstandigheden. Die omstandigheden hoeven het onderzoek niet ongeldig te maken, maar ze horen wel bij de kwaliteitsbeoordeling.
Een hogere foutfrequentie in het tweede blok kan wijzen op moeite met omschakelen, een onduidelijke instructie of verminderde aandacht. Je kunt dat niet automatisch als 'sterkere negatieve associatie' bestempelen. Kijk naar de gezamenlijke patronen van correcte responstijden, fouten en taakvolgorde.
Ook de scoringsmethode speelt mee. De klassieke D-scoreprocedure houdt rekening met verschillen in algemene reactiesnelheid en verwerkt fouten volgens gespecificeerde regels [2]. Maar geen scoringsmethode verandert slechte instructies of onvergelijkbare stimuli achteraf in een goed experiment.
Toetszijden, categorieën en stimulusvolgorde
Er is nog een subtieler probleem. Niet alleen de volgorde van de twee gecombineerde blokken kan verschil maken. Ook welke categorie aanvankelijk links of rechts staat en hoe de stimuli door de taak heen worden aangeboden, kan van invloed zijn.
De aanbevelingen uit 2022 behandelen daarom onder meer het balanceren van antwoordzijden, zorgvuldig gekozen voorbeelden per categorie en het vermijden van lange reeksen waarbij steeds dezelfde toets correct is [7]. Zulke reeksen kunnen reacties versnellen door herhaling van motorische antwoorden, zonder verandering in de onderzochte associatie.
Stimulusselectie vraagt eveneens aandacht. Woorden kunnen in lengte, bekendheid of leesmoeilijkheid verschillen. Een vertaling naar Duits of Engels verandert soms precies die eigenschappen. Een drietalig onderzoek mag daarom niet automatisch aannemen dat dezelfde begrippen in iedere taal dezelfde taakmoeilijkheid hebben.
De regel is eenvoudig: wil je twee psychologische condities vergelijken, laat dan zo min mogelijk andere factoren systematisch meeveranderen. Wat niet gelijk gehouden kan worden, moet worden gerandomiseerd, gebalanceerd, gemeten of als beperking benoemd.
Fictief voorbeeld: een werkgever en twee taakvolgordes
Een fictief onderzoeksbureau laat honderd deelnemers twee combinaties van een impliciete taak uitvoeren. De helft begint met werkgever A en vertrouwen, de andere helft met werkgever B en vertrouwen. De cijfers hieronder zijn uitsluitend illustratief en geen Neurofactor-resultaten.
| Conditievolgorde | Illustratief verschil in gemiddelde tijd | Mogelijke interpretatie |
|---|---|---|
| Eerst A-combinatie, daarna B-combinatie | 95 ms | Kan zowel inhoudelijk verschil als volgorde-invloed bevatten |
| Eerst B-combinatie, daarna A-combinatie | 35 ms | Het verschil is kleiner bij omgekeerde volgorde |
Een oppervlakkige analyse zou een gemiddeld verschil rapporteren en stoppen. Een goede onderzoeker vraagt waarom het getal afhangt van de volgorde. Is de omschakeloefening te kort? Is de eerste gecombineerde taak systematisch gemakkelijker? Is de foutfrequentie vergelijkbaar? En blijft het patroon overeind na een analyse die de volgorde meeneemt?
Dit voorbeeld geeft geen bewijs dat A of B aantrekkelijker is. Het laat zien waarom je eerst het ontwerp en de verdeling van deelnemers moet begrijpen voordat je psychologische betekenis toekent aan een reactietijdverschil.
Een robuust protocol opstellen: zeven beslissingen
1. Definieer de onderzoeksvraag. Gaat het om een relatieve associatie tussen twee categorieën, een vergelijking tussen segmenten of een verandering over de tijd? De meetopzet verschilt per vraag.
2. Leg de taakvariant vast. Beschrijf categorieën, stimuli, antwoordtoetsen, blokindeling, oefenblokken en de exacte uitvoering. Verwijs waar passend naar een bestaand gevalideerd protocol.
3. Kies vooraf de counterbalancing. Verdeel de gecombineerde taakvolgordes over deelnemers. Doe dit ook binnen experimentele condities en relevante strata waar de onderzoeksvraag dat vereist.
4. Zorg voor voldoende oefening. Controleer of de instructies begrijpelijk zijn en of de deelnemer kan omschakelen naar een nieuwe toewijzing. Onderbouw het aantal trials.
5. Leg fout- en uitsluitingsregels vast. Beschrijf voordat je analyseert hoe incorrecte responsen, onwaarschijnlijk snelle of langzame antwoorden en onvolledige sessies worden verwerkt.
6. Controleer procedure- en groepseffecten. Analyseer zo nodig het interactiepatroon tussen volgorde en conditie. Geef niet alleen één samenvattend getal als er relevante verschillen tussen volgordes bestaan.
7. Rapporteer beperkingen. Vermeld wat de taak wel ondersteunt, wat niet, en welke bijkomende gegevens nodig zijn voor een besluit over een merk, werkgever of interventie.
Zo wordt de meetopzet toetsbaar. Een opdrachtgever kan dan zien dat niet alleen het eindcijfer, maar ook de weg ernaartoe zorgvuldig is behandeld.
Hoe herken je een mogelijk procedure-effect in de data?
Een controle begint vaak met simpele, interpreteerbare uitsplitsingen. Vergelijk de reactietijd- en foutpatronen per taakblok en per gebruikte volgorde. Controleer of de groepen vergelijkbare aantallen deelnemers bevatten en of de uitval verschilt. Bekijk of prestaties binnen blokken systematisch sneller worden, of de omschakeling tijdelijke vertraging oplevert en of afwijkingen in één specifiek apparaat of taalversie geconcentreerd zijn.
Ga niet achteraf willekeurig blokken verwijderen totdat de gewenste score verschijnt. Een aangepaste analyse kan zinvol zijn, maar moet methodologisch worden gemotiveerd en transparant worden gerapporteerd. Wanneer een verkennende analyse een onverwacht volgorde-effect laat zien, verdient die ontdekking juist een plaats in het verslag.
De methodespecifieke variantie die Mierke en Klauer onderzochten en de discussie over andere IAT-processen, zoals verschillen in opvallendheid tussen categorieën, herinneren eraan dat de gemeten score niet op slechts één psychologisch mechanisme terug te voeren is [4, 6].
Betrouwbaarheid, validiteit en causaliteit zijn drie verschillende vragen
Een taak kan behoorlijk betrouwbaar worden afgenomen en toch systematisch beïnvloed zijn door een ongewenste procedurefactor. Omgekeerd kan een effect in theorie inhoudelijk relevant zijn, terwijl de meting door ruis te weinig stabiel is. En zelfs een goed gemeten verschil zegt niet vanzelf welke interventie dat verschil veroorzaakt.
Betrouwbaarheid gaat over de consistentie en meetfout van uitkomsten. Validiteit gaat over de vraag of de gekozen taak de beoogde interpretatie voldoende ondersteunt. Causaliteit gaat over het onderbouwen van oorzaak en gevolg. Counterbalancing raakt aan onderzoeksdesign en interpretatie, maar vervangt geen van deze controles.
Voor de betrouwbaarheid van associatieonderzoek werken we deze vraag afzonderlijk uit in kennisbankartikel NF-AS-KB-009. Dat nieuwe artikel wordt pas gelinkt zodra het is gepubliceerd. Voor de basis van responslatenties verwijzen we naar kennisbankartikel NF-AS-KB-007 [2, 7].
Wat hoort minimaal in een onderzoeksrapport?
Een opdrachtgever moet meer ontvangen dan een staafdiagram met twee gemiddelden. Een bruikbaar rapport toont welke categorieën en stimuli zijn gebruikt, welke taakvolgordes voorkwamen, hoe deelnemers over die volgordes zijn verdeeld, welke oefenblokken zijn gebruikt en hoe fouten zijn verwerkt.
Daarnaast zijn de feitelijke aantallen deelnemers, uitval, relevante kwaliteitscriteria, onzekerheid rond de uitkomsten en de gekozen analysemethode nodig. Is er een interventie getest, dan hoort erbij hoe de controlegroep en de meetmomenten zijn ingericht.
Het belangrijkste is dat de conclusie past bij het bewijs. 'In deze taak en deze steekproef zien we een relatief prestatieverschil, na controle voor blokvolgorde' is iets anders dan 'we hebben de verborgen voorkeur van alle kandidaten aangetoond'. De eerste uitspraak kan binnen een goed ontwerp verdedigbaar zijn; de tweede gaat veel verder.
Veelgemaakte fouten bij associatiemetingen
- Iedereen krijgt dezelfde volgorde. Dan is het moeilijk te onderscheiden of een geobserveerd verschil bij de categorieën of bij het taakverloop hoort.
- Geen omschakeloefening. De tweede conditie wordt onnodig benadeeld doordat deelnemers nog in de eerste antwoordregel zitten.
- Een pre-postverschil automatisch als interventie-effect zien. Herhaalde testervaring is een alternatieve verklaring [7].
- Alleen reactietijden rapporteren. Fouten en het verschil tussen snelheid en nauwkeurigheid blijven buiten beeld.
- Een ongebalanceerde steekproef verbergen achter het totaalgemiddelde. Kleine subgroepen kunnen andere procedurepatronen hebben.
- Een score van één taakvariant als universeel beschouwen. Aanbevelingen voor de klassieke IAT zijn niet per definitie bewezen voor elke aangepaste taak.
- Een inhoudelijke claim sterker maken dan de data toestaan. Een procedureel goed uitgevoerde associatietaak voorspelt nog geen individuele aankoop of sollicitatie.
Conclusie: eerst een eerlijk ontwerp, dan een betekenisvolle score
Een goed associatieonderzoek begint niet bij de vraag hoe snel mensen kunnen reageren. Het begint bij de vraag welke vergelijking nodig is om iets zinvols te leren. Taakvolgorde, oefening, herhaling en vermoeidheid zijn geen details die je na afloop uit het verslag kunt laten. Ze zijn onderdeel van wat je hebt gemeten.
Counterbalancing, passende oefening en transparante rapportage verminderen het risico dat een procedureverschil wordt aangezien voor een verschil in associaties. Ze nemen niet alle onzekerheid weg. Wel helpen ze het onderzoek eerlijker, controleerbaarder en bruikbaarder te maken.
Wil je een onderzoeksopzet beoordelen? Vraag dan niet alleen naar de uitkomst, maar ook: wie kreeg welke taak eerst, hoeveel is er geoefend en wat gebeurde er bij herhaling? Juist die drie vragen maken het verschil tussen een overtuigend getal en overtuigend bewijs.
Begrippen
- Volgorde-effect
- Invloed van de positie of volgorde van taken, stimuli of meetmomenten op de gemeten prestatie.
- Oefeneffect
- Verandering in taakprestatie doordat een deelnemer de taakregels, stimuli of antwoordhandelingen leert kennen.
- Counterbalancing
- Doelbewuste verdeling van mogelijke taakvolgordes en, waar passend, antwoordtoetsindelingen over onderzoekscondities.
- Task-set inertia
- Doorwerking van een eerder aangeleerde taakinstelling nadat een andere taakregel is ingevoerd.
- Omschakeloefening
- Oefenfase waarin deelnemers de nieuwe categorisatie of toetsindeling aanleren vóór de volgende gecombineerde taak.
- Pre-postmeting
- Onderzoeksopzet waarin dezelfde relevante uitkomst voor en na een gebeurtenis of interventie wordt gemeten; een verschil is zonder verdere controle geen causaal bewijs.
Veelgestelde vragen
Is een volgorde-effect hetzelfde als een associatie-effect?
Nee. Een volgorde-effect komt voort uit de plaats van een taak in de procedure. Een associatie-effect is een theoretisch bedoelde relatie tussen begrippen. In dezelfde gemeten score kunnen beide bijdragen voorkomen. Een goede onderzoeksopzet probeert dat onderscheid zichtbaar te maken.
Moet ik bij elke IAT de volgorde van taakblokken omwisselen?
Voor klassiek IAT-onderzoek is het doorgaans wenselijk om de twee gecombineerde taakvolgordes over deelnemers te balanceren. De precieze aanpak hangt af van de onderzoeksopzet en het type analyse. Gebruik een onderbouwd protocol, geen universele checklist zonder context [7].
Waarom geven onderzoekers extra oefenblokken?
Deelnemers moeten de toetsindeling begrijpen en na een omschakeling een eerdere regel kunnen loslaten. Extra oefening vóór de omgekeerde gecombineerde taak heeft in klassiek IAT-onderzoek de invloed van blokvolgorde verminderd [3]. De juiste hoeveelheid moet bij de taak passen.
Als deelnemers bij de tweede test sneller zijn, zijn hun associaties dan veranderd?
Niet noodzakelijk. Algemene taakbekendheid, gewijzigde voorzichtigheid, de volgorde van de blokken en herhaalde blootstelling kunnen prestaties beïnvloeden. Een verandering in taakscore is pas inhoudelijk interpreteerbaar wanneer relevante alternatieve verklaringen zijn onderzocht.
Kan counterbalancing alle vertekening verwijderen?
Nee. Counterbalancing helpt volgorde-effecten over condities te verdelen en te analyseren, maar lost geen problemen op met onduidelijke stimuli, fouten, ongelijke uitval, slechte hardware of onjuiste interpretatie. Het is één onderdeel van een breder kwaliteitsprotocol.
Is een pre-postmeting zonder controlegroep voldoende om effect te bewijzen?
Meestal niet wanneer je een oorzakelijke conclusie wilt trekken. In een herhaalde IAT kan de score ook door testervaring veranderen. Een passende controlegroep of voorafgaande taakervaring kan helpen de alternatieve verklaring te beperken [7].
Hoe herken ik vermoeidheid of een snelheid-nauwkeurigheidsafweging?
Bekijk niet alleen gemiddelde reactietijden, maar ook fouten, variatie, positie in de sessie, uitval en veranderingen tijdens de taak. Deze aanwijzingen kunnen kwaliteitsproblemen zichtbaar maken, maar bewijzen op zichzelf geen specifieke mentale toestand.
Gelden deze aanbevelingen ook voor Neurofactor's RIAT en andere associatietaken?
Het algemene belang van volgorde, taakleren en nauwkeurigheid is breder toepasbaar. Maar concrete aanbevelingen uit de klassieke IAT-literatuur, zoals specifieke blokopbouw of scoringsregels, zijn niet zonder taakgerichte validatie overdraagbaar op iedere RIAT- of andere associatievariant.
Bronnen
- 1.Greenwald, A. G., McGhee, D. E., & Schwartz, J. L. K. (1998). Measuring individual differences in implicit cognition: The Implicit Association Test. Journal of Personality and Social Psychology. - Journal of Personality and Social Psychology (1998)
- 2.Greenwald, A. G., Nosek, B. A., & Banaji, M. R. (2003). Understanding and using the Implicit Association Test: I. An improved scoring algorithm. Journal of Personality and Social Psychology. - Journal of Personality and Social Psychology (2003)
- 3.Nosek, B. A., Greenwald, A. G., & Banaji, M. R. (2005). Understanding and using the Implicit Association Test: II. Method variables and construct validity. Personality and Social Psychology Bulletin. - Personality and Social Psychology Bulletin (2005)
- 4.Mierke, J., & Klauer, K. C. (2003). Method-specific variance in the Implicit Association Test. Journal of Personality and Social Psychology. - Journal of Personality and Social Psychology (2003)
- 5.Klauer, K. C., & Mierke, J. (2005). Task-set inertia, attitude accessibility, and compatibility-order effects: New evidence for a task-set switching account of the Implicit Association Test effect. Personality and Social Psychology Bulletin. - Personality and Social Psychology Bulletin (2005)
- 6.Rothermund, K., & Wentura, D. (2004). Underlying processes in the Implicit Association Test: Dissociating salience from associations. Journal of Experimental Psychology: General. - Journal of Experimental Psychology: General (2004)
- 7.Greenwald, A. G., Brendl, M., Cai, H., et al. (2022). Best research practices for using the Implicit Association Test. Behavior Research Methods. - Behavior Research Methods (2022)
Verwante onderwerpen
Gecontroleerd door: Martijn den Otter · Laatst gecontroleerd: 4-11-2026
Martijn den Otter
Oprichter van Neurofactor. Expert in neuromarketing en consumentenpsychologie.
LinkedIn →